
Onyx: chat con documentos de empresa y sus permisos
«Quiero un ChatGPT que conozca nuestros documentos.» Es de las peticiones de IA que más se repiten en una pyme, y tiene sentido: los procedimientos, las ofertas y los manuales están repartidos entre Drive, SharePoint y el correo, y nadie encuentra nada. Onyx (antes Danswer) es uno de los proyectos libres más completos para montar un chat con documentos de empresa. No lo uso con ningún cliente; lo analizamos leyendo su código fuente en noviembre de 2026, sin ejecutarlo.
El análisis gira alrededor de un problema que casi nunca sale en las demos: los permisos.
El problema: un buscador que ha leído todo
Estos sistemas se llaman RAG (generación aumentada con recuperación). Funcionan en dos fases:
- Indexación: un proceso recorre las fuentes conectadas, trocea cada documento en fragmentos y los guarda en un índice con una representación numérica de su significado (embeddings).
- Respuesta: cuando alguien pregunta, el sistema busca los fragmentos más parecidos, se los pasa a un modelo de lenguaje y este redacta la respuesta citando de dónde sale.
El riesgo está en la primera fase. Si el conector entra en Google Drive con una cuenta de administrador, indexa todo lo que esa cuenta ve: nóminas, evaluaciones, contratos, la carpeta de dirección. Si luego el índice no sabe quién puede ver cada fragmento, cualquier empleado puede preguntar «¿cuánto cobra el director comercial?» y el chat le contesta con la nómina delante. Nadie ha saltado ninguna seguridad: el sistema hace exactamente lo que se le pidió.
Por eso, en un RAG interno, la pregunta importante es si respeta los permisos que el documento tiene en origen, más allá de lo bien que conteste.
Qué monta Onyx
Según su docker-compose.yml, la instalación estándar son 11 contenedores, de los que solo el proxy nginx publica puertos:
- Servidor de la API en Python (FastAPI) e interfaz en Next.js.
- PostgreSQL y Redis (caché).
- OpenSearch como índice vectorial y de palabras clave.
- Trabajos en segundo plano con Celery: nueve tipos de worker que sincronizan las fuentes, procesan documentos y lanzan tareas programadas.
- Dos servidores de modelos que calculan los embeddings en local.
- Un servidor MCP y un entorno aislado para ejecutar código.
Los conectores están en backend/onyx/connectors/: su README habla de más de 50 aplicaciones, entre ellas Google Drive, Gmail, SharePoint, OneDrive, Outlook, Teams, Slack, Confluence, Jira, HubSpot o Salesforce.
No es ligero. Su documentación pide como mínimo 4 vCPU, 10 GB de RAM y 32 GB de disco, más unas 2,5 veces el volumen indexado; recomienda 8 vCPU y 16 GB. Existe un modo Lite que funciona con 2 GB, pero desactiva OpenSearch y los trabajos de fondo, así que no indexa documentos: queda un chat con agentes, sin la parte que interesa aquí.
Cómo decide Onyx quién ve cada documento
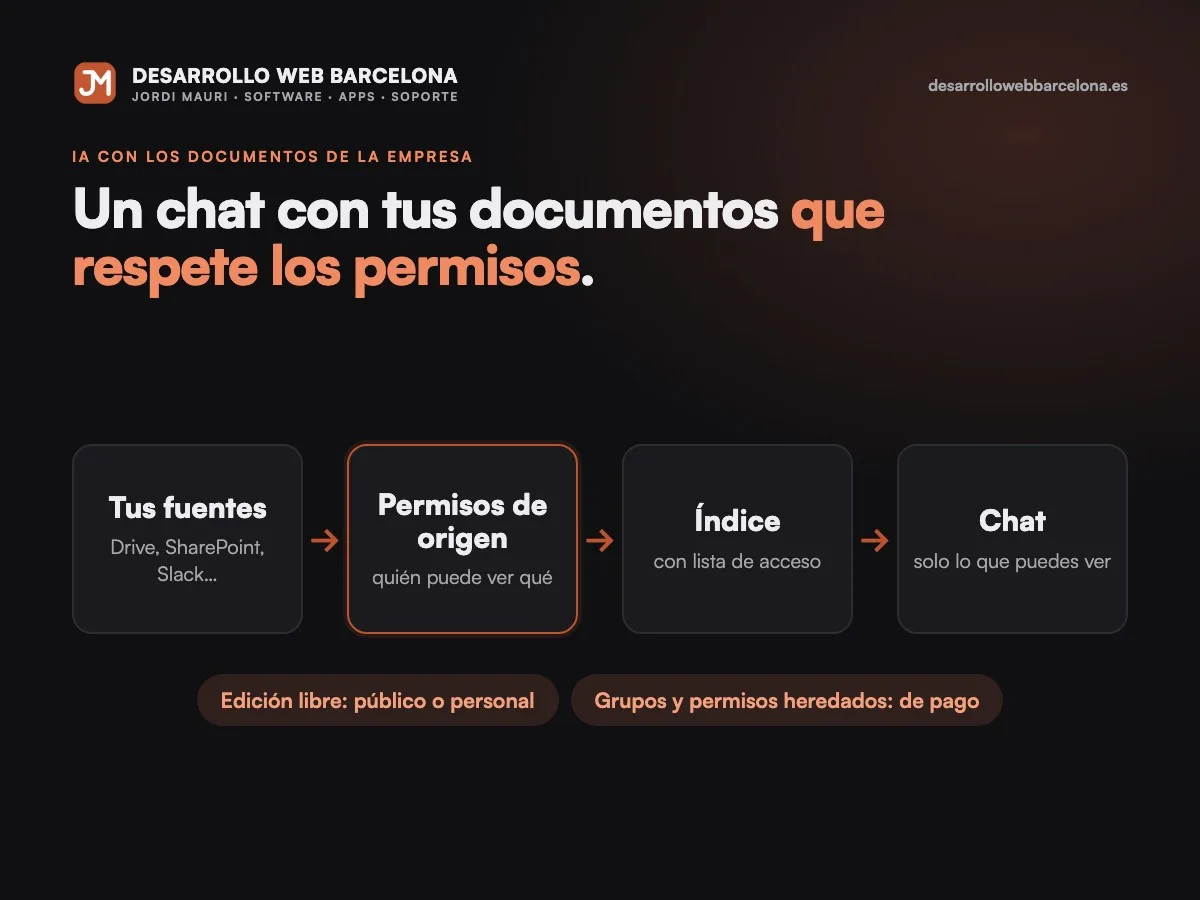
Comprobamos en su código que cada fragmento indexado lleva una lista de control de acceso, y cada usuario tiene la suya. Un usuario ve un fragmento si las dos listas coinciden en al menos un elemento (backend/onyx/access/access.py).
En la edición libre, esa lista se calcula con muy poco. La función que reúne el acceso de cada documento (get_access_info_for_documents, en backend/onyx/db/document.py) mira dos cosas:
- Si la conexión está marcada como pública: entonces el documento lo ve cualquier usuario de Onyx.
- Quién es el dueño de la credencial con la que se conectó la fuente: ese usuario lo ve.
Hay además un modo personal, en el que solo lee los documentos el dueño de la credencial y no se pueden añadir grupos. Lo que no hay en la edición libre son grupos: un comentario del propio código lo dice sin rodeos, «MIT version will wipe all groups and external groups on update».
Traducido a una pyme: si conectas la unidad compartida de la empresa en modo público, todos ven todo lo que ve la cuenta que usaste. Si la conectas en modo privado o personal, solo la ve una persona. No hay un término medio del tipo «el equipo de obra ve esta carpeta y administración, esa otra».
Lo que es de pago: heredar los permisos de origen
El término medio existe, pero está en la parte de pago. El repositorio separa el código: lo que está fuera de las carpetas ee es MIT y lo puedes usar y modificar sin restricciones; lo que está dentro, bajo la Onyx Enterprise License, solo se puede usar en producción con suscripción. Hay incluso un espejo del repositorio sin la carpeta ee para quien no quiera ni tenerla en disco.
En backend/ee/onyx/external_permissions/ está la sincronización de permisos con cada fuente: Google Drive, Gmail, SharePoint, OneDrive, Outlook, Teams, Slack, Confluence, Jira, GitHub, Salesforce y otras. Es lo que hace que un fragmento de Drive solo lo vea quien puede abrir ese fichero en Drive. También es de pago el filtrado posterior a la búsqueda para las fuentes donde el permiso se decide en el momento de leer.
Su documentación lo clasifica en el plan Business, junto con los grupos de usuarios, varios proveedores de SSO a la vez, la marca propia y el cifrado de las credenciales de los conectores. Según su página de precios, a noviembre de 2026 Business se paga por usuario y mes, con facturación anual. Esa misma página solo menciona el despliegue en servidor propio en el plan Enterprise, con precio a consultar; antes de presupuestar una instalación propia con permisos, hay que preguntárselo a ellos.
Modelo local o en la nube
Hay dos modelos distintos en juego, y conviene no mezclarlos:
- Embeddings: por defecto se calculan en tu servidor con un modelo pequeño y multilingüe de IBM (
granite-embedding-97m-multilingual-r2, enbackend/shared_configs/configs.py). Los documentos no salen del servidor para indexarse. - Modelo que redacta la respuesta: según su README, admite proveedores en la nube (OpenAI, Anthropic, Gemini) y modelos locales a través de Ollama, vLLM o LiteLLM.
Si eliges un modelo en la nube, a ese proveedor le llega la pregunta y los fragmentos recuperados para contestarla, no el índice entero. Que esos fragmentos sean solo los que el usuario puede ver depende, otra vez, de los permisos. Un modelo local evita la salida de datos, pero pide un servidor con bastante más memoria, y en castellano los modelos pequeños contestan peor.
Si lo que buscas es construir asistentes o flujos con IA a medida (un chatbot para la web, un flujo que clasifica correos), Dify cuadra mejor que Onyx. Su licencia es distinta: Apache 2.0 modificada, que impide usarlo como servicio con varios espacios de trabajo para clientes sin licencia comercial.
Cuándo conviene un chat con documentos de empresa
Conviene si tienes documentación repartida en Drive, SharePoint o Confluence que toda la plantilla puede ver (procedimientos, fichas técnicas, catálogos, preguntas frecuentes internas), un servidor con 16 GB de RAM y alguien que lo mantenga. También si estás dispuesto a pagar el plan con permisos cuando el contenido se compartimenta.
No conviene si tus fuentes mezclan documentación general con nóminas, recursos humanos o dirección y no vas a pagar la sincronización de permisos. Si aun así quieres la edición libre, lo prudente es conectar solo carpetas que ya son de todos y dejar fuera las sensibles, en lugar de confiar en que el chat no las mencione. Tampoco conviene si solo tienes un VPS pequeño: el modo Lite no indexa.
Si estás pensando en dar a tu equipo un chat sobre los documentos de la empresa y quieres que miremos qué fuentes conectar y cómo no enseñar lo que no toca, escríbeme desde la web. Aquí cuento cómo trabajo la inteligencia artificial para empresas.
Fuentes
Preguntas frecuentes
¿Onyx respeta los permisos de Google Drive o SharePoint?
Solo en la parte de pago. La sincronización de permisos con cada fuente está en el código Enterprise; en la edición libre, un documento lo ve cualquier usuario si la conexión es pública, o solo el dueño de la credencial si es privada o personal.
¿Qué servidor necesita Onyx?
Su documentación pide como mínimo 4 vCPU, 10 GB de RAM y 32 GB de disco, más unas 2,5 veces el volumen indexado, y recomienda 8 vCPU y 16 GB. El modo Lite funciona con 2 GB, pero no indexa documentos.
¿Los documentos salen del servidor si uso un modelo en la nube?
Los embeddings se calculan por defecto en tu servidor, así que el índice no sale. Al proveedor del modelo en la nube le llegan la pregunta y los fragmentos recuperados para contestarla.
Sobre cómo escribo estos artículos: preparo los contenidos con ayuda de herramientas de inteligencia artificial y después los reviso, corrijo y publico yo. La responsabilidad editorial de lo que leas aquí es mía.
¿Tienes un proyecto en mente?
Cuéntame qué necesitas y lo sacamos adelante. Respuesta rápida y sin compromiso.
Hablemos →