
IA en local con Ollama: qué modelo cabe y cómo no dejarlo abierto
Ollama descarga modelos de lenguaje abiertos (Gemma, Qwen, gpt-oss…) y los sirve por una API HTTP desde tu propio equipo. Uso IA en local con Ollama en mi portátil, en un mini PC que hace de servidor y en un VPS, y en las tres máquinas me hago las mismas dos preguntas: qué modelo cabe y cómo evito que cualquiera pueda usarlo. Respondo con números medidos por mí y con lo que dice su código.
Para qué uso IA en local (y para qué no)
El motivo principal es que los datos no salen de la máquina. Un ejemplo real: para Aizelio, una plataforma de atención sanitaria en eventos, montamos en el entorno de pruebas un redactor que convierte los recuentos de un evento (atenciones por tipo) en un párrafo de informe. El modelo corre en el propio servidor y, por diseño, solo recibe números: la función que lo llama no tiene ningún campo donde quepa un nombre o una descripción clínica, y el texto que escribe el modelo no se guarda.
Ese mismo caso enseña el límite. Probamos el mismo encargo ocho veces con tres modelos pequeños:
- Un modelo de 1.000 millones de parámetros acertó 1 de 8. Escribía «30 tapones y 2 tiritas» cuando era al revés: la frase sonaba perfecta y el número estaba mal.
- Uno de 1.700 millones acertó 4 de 8.
- Uno de 4.000 millones acertó 8 de 8, en unos 2,7 segundos.
Antes de poner un modelo en producción hay que pasarle una batería de casos y contar los aciertos: el más pequeño que «parece funcionar» falla donde más duele.
Para lo que no lo uso: escribir código serio. Los dos modelos de 9.000 y 12.000 millones que probamos se inventaron funciones de Swift que no existen.
Qué modelo cabe en cada equipo
La memoria manda. Un modelo ocupa en RAM (o en VRAM, si hay tarjeta gráfica) aproximadamente lo que pesa en disco, más lo que necesite el contexto. Con mis propias descargas, la cuenta sale así:
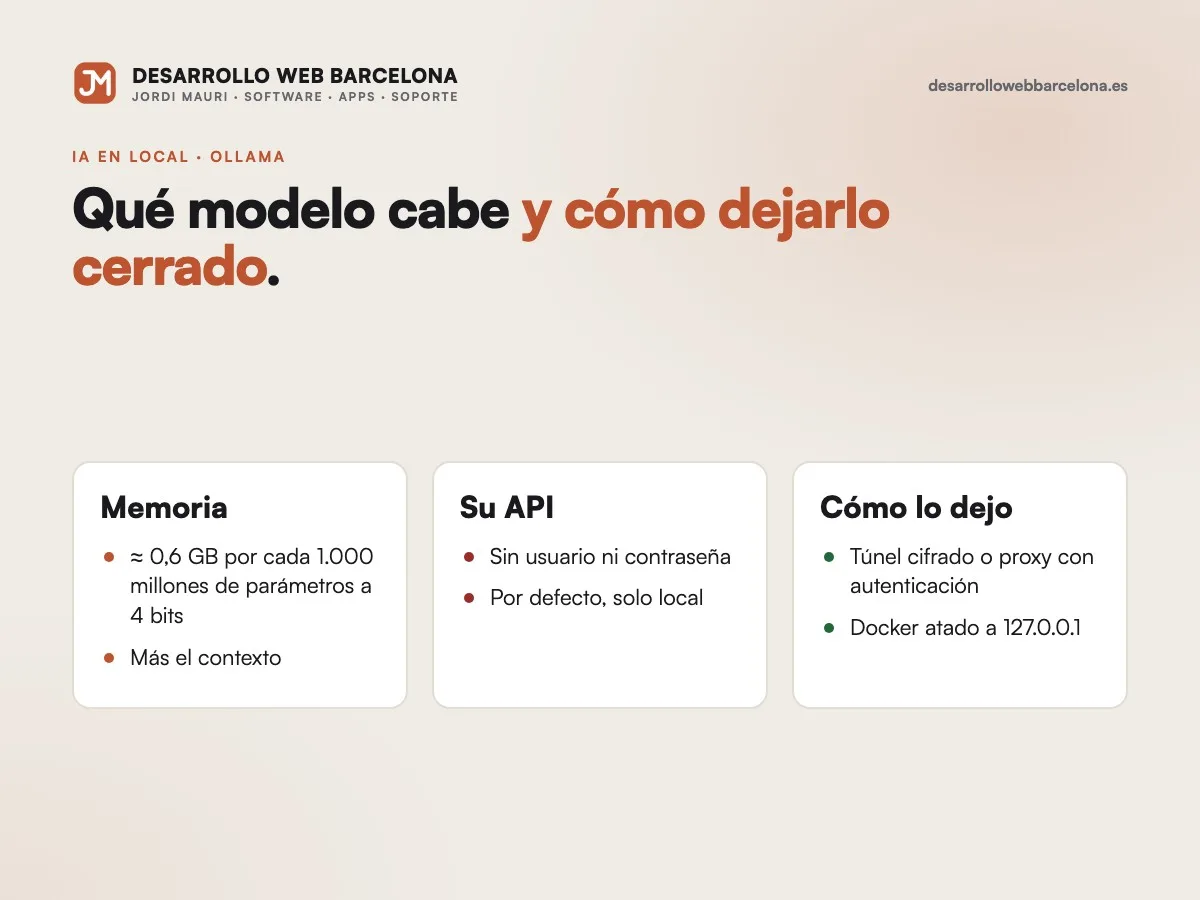
- Cuantizado a 4 bits: unos 0,6 GB por cada 1.000 millones de parámetros. Un modelo de 27.000 millones pesaba 17 GB.
- Cuantizado a 8 bits: algo más de 1 GB por cada 1.000 millones. Un modelo de 12.000 millones pesaba 13 GB, y uno de 4.000 millones, 5 GB.
A eso hay que sumar el contexto. Según la documentación de Ollama, el contexto por defecto se ajusta a la memoria de vídeo: 4.000 tokens con menos de 24 GiB, 32.000 entre 24 y 48 GiB y 256.000 a partir de 48 GiB. Y la memoria crece al multiplicar las peticiones simultáneas por la longitud del contexto, así que servir a cinco personas a la vez no cuesta lo mismo que servir a una.
Lo que comprobamos midiendo en nuestras máquinas:
| Equipo | Modelo | Memoria | Generación |
|---|---|---|---|
| Portátil Apple M2 Max, 32 GB | Gemma 4 de 12.000 millones | 8,4 GB | 18-21 tokens/s |
| Portátil Apple M2 Max, 32 GB | Qwen 3.5 de 9.000 millones | 6,6 GB | 23-32 tokens/s |
| Portátil Apple M2 Max, 32 GB | gpt-oss de 20.000 millones | 12,8 GB | 30-45 tokens/s |
| Portátil Apple M2 Max, 32 GB | modelo de 27.000 millones a 4 bits | 17,4 GB | 6-14 tokens/s |
| Mini PC sin tarjeta gráfica | Gemma 3 de 12.000 millones a 8 bits | 13 GB | 5-10 tokens/s |
| Mini PC sin tarjeta gráfica | Gemma 3 de 4.000 millones a 8 bits | 5 GB | unos 20 tokens/s |
El de 27.000 millones cabía, pero con el navegador y el editor abiertos el Mac se quedó al 9 % de RAM libre y con 11 GB de intercambio en disco, y ahí la respuesta se arrastra. En 32 GB compartidos con el resto del trabajo, mi límite cómodo está en torno a los 12.000 millones de parámetros.
En el VPS (8 núcleos virtuales, 16 GB y sin GPU) el modelo de 4.000 millones hace bien su trabajo para párrafos cortos.
El tiempo se va en leer, no en escribir
Una sorpresa de las mediciones: en un asistente con instrucciones largas, casi todo el tiempo se va en procesar el texto de entrada. En una prueba, el modelo tardó 15,2 segundos en digerir 3.049 tokens de contexto y 0,04 segundos en escribir la respuesta.
Ollama reutiliza lo ya procesado si el principio del prompt no cambia entre mensajes. Una aplicación que recorta el historial «por la ventana», quitando un mensaje antiguo en cada turno, rompe esa reutilización y paga el contexto entero cada vez. Al recortar por bloques, el turno bajó de unos 11 segundos a 0,4.
Ojo también con OLLAMA_KEEP_ALIVE: por defecto, el modelo sale de memoria a los 5 minutos sin uso y el siguiente mensaje empieza recargándolo.
Lo delicado: la API no pide contraseña
Este es el punto que más me importa del artículo. La API de Ollama no tiene autenticación. En su código (server/routes.go) la única comprobación es sobre la cabecera Host de la petición, y esa comprobación se salta en cuanto el servidor escucha en una dirección que no es la local.
Por defecto no pasa nada, porque Ollama escucha solo en 127.0.0.1, la propia máquina. El problema llega cuando lo cambias con OLLAMA_HOST para usarlo desde otro equipo. A partir de ahí, quien llegue a esa dirección puede generar texto con tu hardware, descargar modelos que llenen el disco, crear variantes o borrar los que tienes: todo eso son rutas de la misma API, sin usuario ni clave.
Hay un segundo caso que pilla a mucha gente. La imagen oficial de Docker fija OLLAMA_HOST=0.0.0.0 dentro del contenedor, y el ejemplo de la documentación publica el puerto con -p sin indicar dirección. Según la documentación de Docker, eso lo publica en todas las direcciones del equipo, y además Docker y el cortafuegos ufw son incompatibles: el tráfico hacia el contenedor se enruta antes de que ufw aplique sus reglas. Resultado: el «solo local» del valor por defecto desaparece sin que lo hayas decidido.
Cómo lo dejo configurado
Lo que hago, de más a menos restrictivo:
- Solo en la máquina que lo usa. En el portátil lo arranca la aplicación que lo necesita, solo en local, y lo para al cerrarse.
- Atado a una red interna concreta. En el VPS de Aizelio, Ollama escucha únicamente en la red interna de los contenedores de esa aplicación: ni en la interfaz pública ni en la red que comparten las demás aplicaciones del servidor.
- Desde otro equipo, por un canal cifrado. Al Ollama del mini PC entro desde el portátil por un túnel SSH. En una oficina con más gente, además, lo ataría a una interfaz de red concreta.
- Si varias personas lo necesitan, un proxy con autenticación delante. La FAQ de Ollama explica cómo ponerlo detrás de Nginx, pero su ejemplo no añade contraseña: esa parte la pones tú (usuario y clave, token o acceso solo por VPN).
Y tres ajustes más:
- En Docker, publicar con
-p 127.0.0.1:…. - Desactivar las funciones en la nube con
OLLAMA_NO_CLOUD=1si el objetivo es que nada salga del servidor. Vienen activadas. - Revisar la licencia de cada modelo. El programa es MIT; los modelos tienen cada uno la suya.
Cuándo conviene a una pyme y cuándo no
Conviene si tienes datos que no quieres mandar fuera (una asesoría, una clínica, un despacho) y la tarea es acotada: resumir, clasificar, pasar datos a un párrafo, extraer campos de un documento. También si tienes un Mac o un servidor con 8-16 GB libres para él.
No conviene si necesitas la calidad de los modelos grandes de pago para tareas complejas, si tu único servidor es un VPS pequeño compartido con la web, o si buscas una aplicación de chat lista para la plantilla: Ollama es el motor, y la interfaz y los permisos son otra pieza.
Si quieres que veamos qué modelo cabe en tus equipos y cómo dejarlo cerrado, te lo cuento en la página de inteligencia artificial para empresas; si quieres que lo miremos para tu empresa, escríbeme desde la web.
Fuentes
Preguntas frecuentes
¿Qué modelo de IA cabe en mi equipo con Ollama?
Un modelo ocupa en memoria más o menos lo que pesa en disco, más el contexto. Cuantizado a 4 bits son unos 0,6 GB por cada 1.000 millones de parámetros; en un portátil de 32 GB compartido con el resto del trabajo, el límite cómodo está en torno a los 12.000 millones.
¿La API de Ollama tiene contraseña?
No, no tiene autenticación. Por defecto solo escucha en 127.0.0.1, pero si la abres con OLLAMA_HOST o la publicas desde Docker, cualquiera que llegue a esa dirección puede generar texto, descargar modelos o borrarlos.
¿Sirve un modelo pequeño en local para producción?
Depende de la tarea. En una prueba de ocho intentos, un modelo de 1.000 millones de parámetros acertó 1, uno de 1.700 millones acertó 4 y uno de 4.000 millones acertó los 8, así que antes de ponerlo en producción hay que pasarle una batería de casos y contar los aciertos.
Sobre cómo escribo estos artículos: preparo los contenidos con ayuda de herramientas de inteligencia artificial y después los reviso, corrijo y publico yo. La responsabilidad editorial de lo que leas aquí es mía.
¿Tienes un proyecto en mente?
Cuéntame qué necesitas y lo sacamos adelante. Respuesta rápida y sin compromiso.
Hablemos →